什么研究方向值得投入?研究者即使对一个提案的新颖性、技术深度有相近判断,也可能选择不同的方向。我们的新论文 Learning Individual Scientific Taste with Privileged Hindsight Distillation 研究如何让 AI 从少量比较反馈中学习这种个人偏好,支持更贴近研究者自身判断的方向选择。
从共享评价到个人偏好
我们将科研品味建模为:研究者如何把各项评价及其支撑证据转化为相对偏好。候选方向首先进入一个共享的六维评价空间,包括普适性、新颖性、重要性、简约性、深度和算法复杂度;不同研究者再通过各自的权重和依赖具体情境的规则,对同一组评价形成不同取舍。
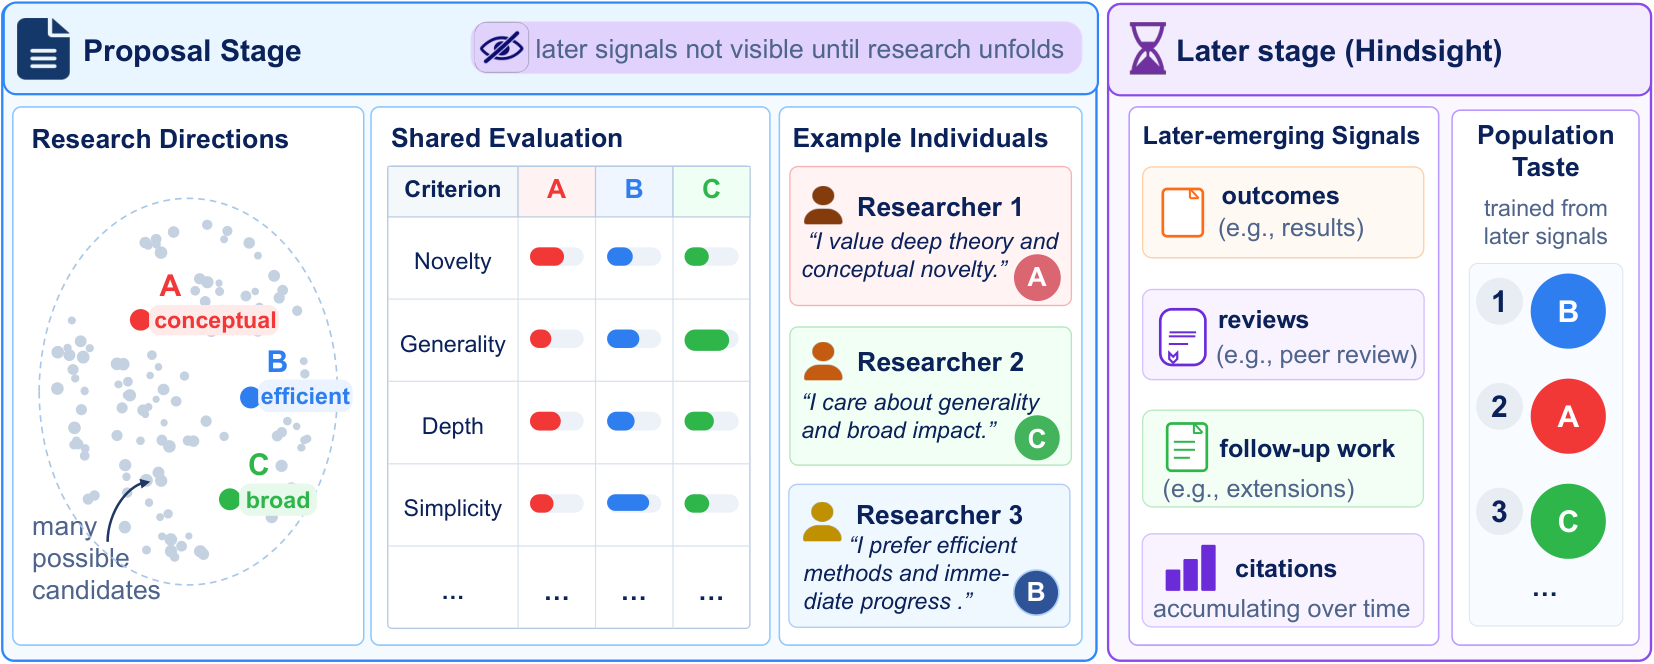
科研品味将共享评价映射为个人偏好。来源:论文图 1。
从事后证据中学习,在提案阶段作判断
特权后见蒸馏(Privileged Hindsight Distillation,PHD) 在训练时利用已完成的研究和后续科学证据,诊断提案阶段的判断错误。在底座模型参数冻结的条件下,教师修订外部评分准则、条件规则和记忆;候选修订经过信息泄漏筛查和留出验证后才会被接受。实际推断时,系统只使用提案阶段可见的信息和已接受的规则材料。
整个框架先学习共享评价和群体偏好映射,再通过研究者反馈进行个人适配。个性化同时调整评价维度权重、引入个人条件规则,并通过交叉拟合回放检查新规则能否保留对既有反馈的正确判断。
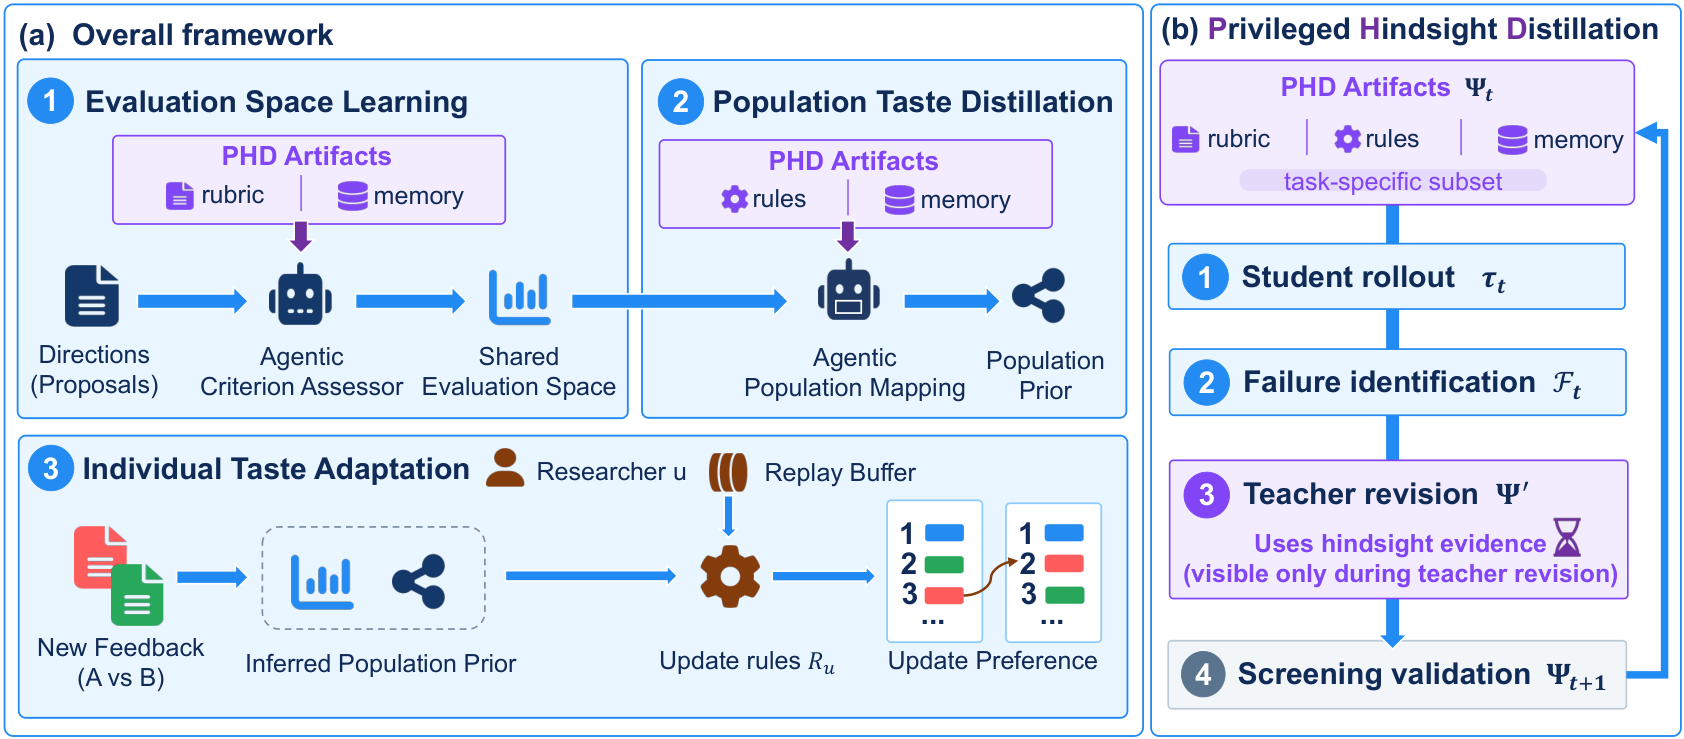
共享评价、群体学习与个人适配的整体流程。来源:论文图 2。
实验说明了什么
在量子研究领域,7 位研究者分别提供 15 次用于适配的比较,以及 10 对留出测试提案。完整方法的 RW-SP 为 0.693,Profile Prompting 为 0.481,FSPO 为 0.642(表 1)。这一指标按研究者的偏好置信度加权,并要求交换提案展示顺序后仍能正确预测。
群体先验本身已较强:真实研究者上的得分为 0.680,仅调整维度权重得到 0.679,加入个人条件规则后达到 0.693(表 4)。因此,相对群体先验的总体提升是有限的;具体案例进一步展示了系统如何恢复不同研究者对同一提案对的相反偏好。
另一项包含 20 位真实研究者的互动研究中,与匹配条件下的 Single Call 基线相比,个性化排序在参与度不相等的竞争提案对中胜率为 0.684(表 3)。参与度记录查看、细化和采纳提案等行为,尚不能据此判断长期科研影响。
对科研助手的启示
随着候选方向的生成成本降低,学习研究者愿意深入探索哪些建议,有望帮助分配有限的注意力。显式表示的偏好映射,也可以成为研究者检查和修订自身偏好的对象,并随兴趣变化持续调整。
当前证据仍受真实专家样本较小、评价维度固定等条件限制。共享组件的参考标签由大模型生成,研究也未控制预训练模型已经掌握的知识。学习到的品味能否持续支持科研推进,还需要更广泛的专家实验和更长时间的跟踪。
论文: Learning Individual Scientific Taste with Privileged Hindsight Distillation · PDF
作者: Hanwei Fan、Yanqiao Wang、Yiqi Zhu、Xuanyu Lei、Peng Li、Yang Liu。
本文依据 2026 年 10 月 14 日提交的 arXiv v1 预印本撰写。